0
AI tóm tắt thiếu ý? Thử bộ kiểm tra 6 ghi chú
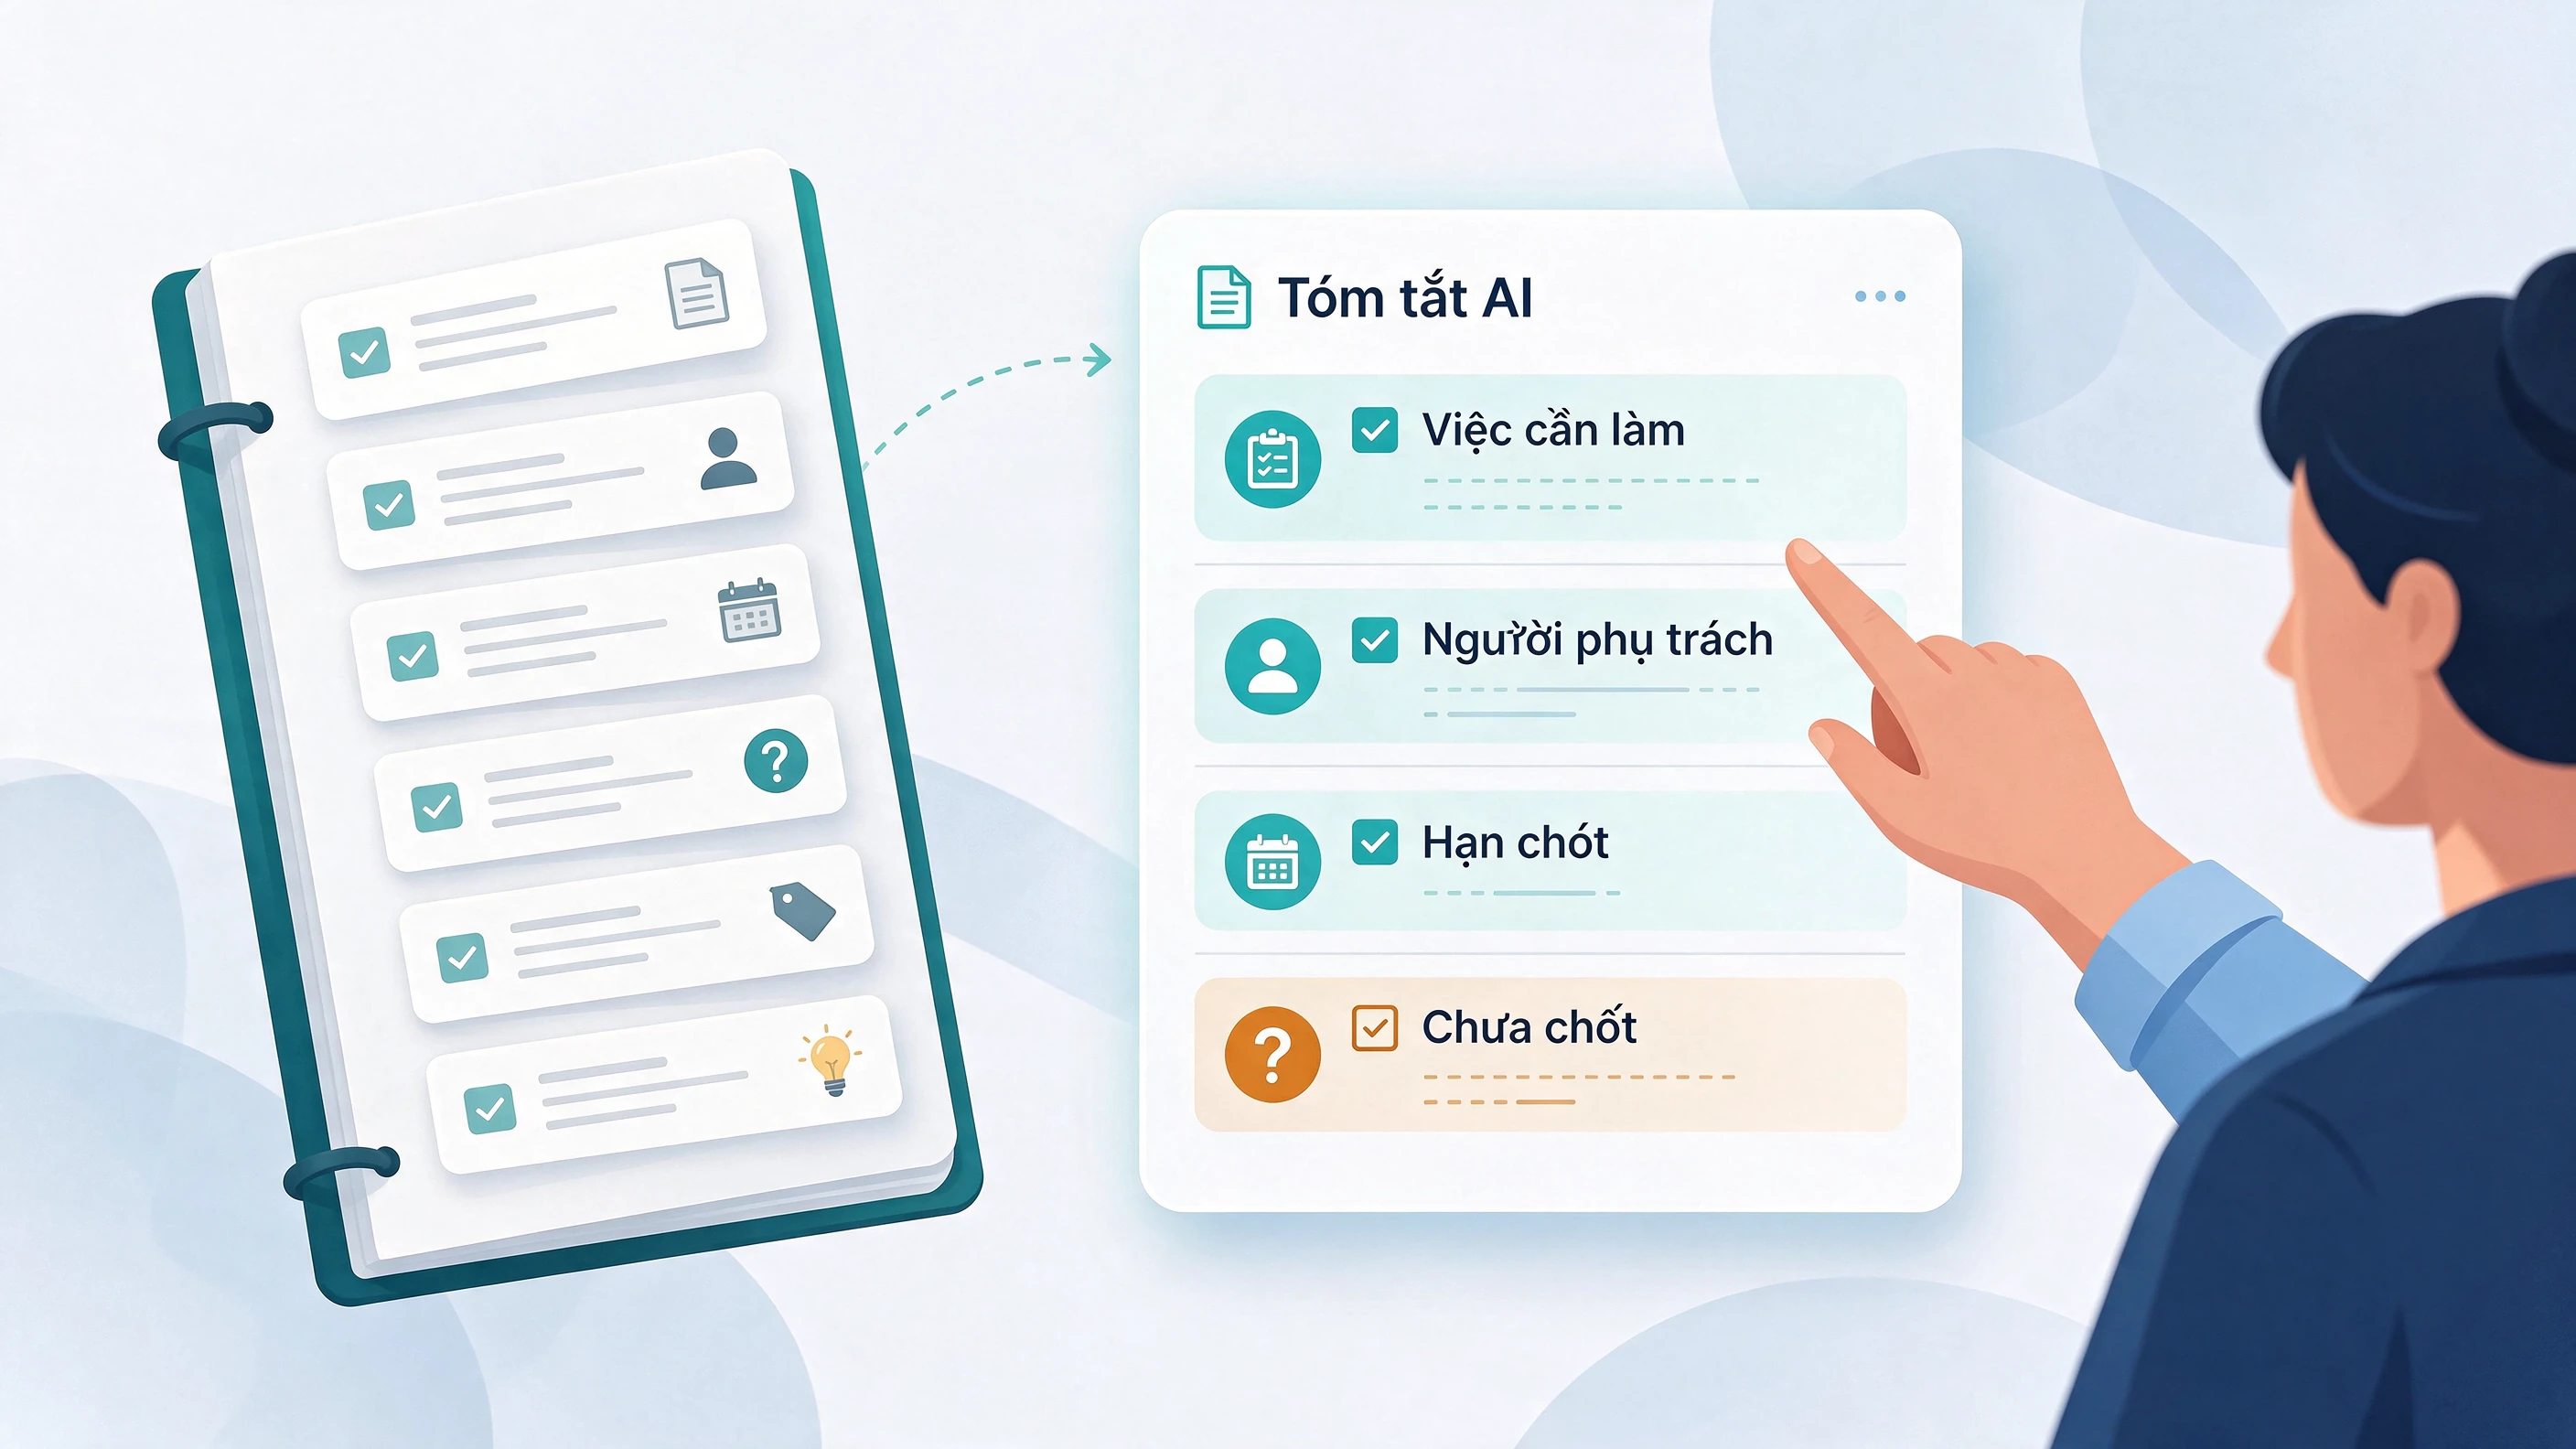 Bạn nhờ AI tóm tắt ghi chú, đọc thấy trôi chảy nhưng đến lúc làm mới phát hiện thiếu người phụ trách hoặc sai hạn chót? Trước khi đổi prompt liên tục, hãy giữ lại vài đầu vào có đáp án rõ để kiểm tra cùng một lỗi.
Trong một thảo luận công khai gần đây trên r/artificial, người dùng kể việc AI kém ổn định với những tác vụ trước đây làm tốt. Phản hồi trái chiều: có người thấy kết quả tốt hơn; có người đề nghị lưu đầu vào và đầu ra để so thay vì dựa vào trí nhớ. Đây là trải nghiệm cá nhân, không phải bằng chứng rằng các mô hình đều bị giảm chất lượng.
Với riêng việc tóm tắt ghi chú, bạn có thể bắt đầu bằng phép kiểm tra nhỏ dưới đây. Cách làm dựa trên hướng dẫn đánh giá của OpenAI: dùng tác vụ đại diện, xác định tiêu chí trước, lưu kết quả rồi so sánh. Không cần viết code hay đăng ký thêm công cụ trả phí để làm phiên bản thủ công này.
1. Giữ cố định 6 ghi chú thử
Tạo 6 đoạn ngắn, hư cấu hoặc đã loại thông tin nhạy cảm: một ca có đủ người và hạn; một ca có nhiều việc; một ca thiếu người phụ trách; một ca thiếu hạn; một ca có hạn mới thay hạn cũ; một ca có đề xuất chưa được chốt. Viết sẵn đáp án mong đợi cho từng ca, không để AI tự tạo cả đáp án rồi tự xác nhận đúng.
Con số 6 là gợi ý khởi đầu của VionSky, không phải cỡ mẫu chuẩn do nhà cung cấp quy định. Hãy bổ sung những lỗi thật bạn gặp sau này.
2. Thử ngay với một ghi chú hư cấu
Ghi chú đầu vào:
“Họp dự án ngày 18/11: Lan gửi bản nháp cho nhóm trước 20/11. Nhóm chưa thống nhất ai phê duyệt ngân sách. Chưa ghi hạn cho quyết định ngân sách.”
Prompt có thể sao chép:
“Chỉ dùng nội dung ghi chú bên dưới. Tách thành: việc cần làm, người phụ trách, hạn chót và điểm chưa chốt. Giữ nguyên cách ghi thời gian trong nguồn. Nếu thiếu người hoặc hạn, ghi ‘chưa nêu’; không suy đoán hay biến đề xuất thành quyết định. Cuối cùng, trích câu trong ghi chú làm căn cứ cho từng việc. Ghi chú: [dán đoạn cần kiểm tra].”
Kết quả cần có: việc gửi bản nháp thuộc Lan, hạn trước 20/11; người phê duyệt ngân sách chưa thống nhất, hạn chưa nêu. Không được tự gán việc phê duyệt cho Lan hoặc đặt thêm ngày. Đây là đáp án kỳ vọng cho ví dụ, không phải kết quả thử nghiệm của một mô hình cụ thể.
3. Chấm từng ca bằng cùng ba câu hỏi
- Các việc và điểm chưa chốt có được giữ đủ, đúng với nguồn không?
- Người phụ trách và thời hạn có đúng, hoặc được ghi rõ là chưa nêu không?
- Có chi tiết nào bị thêm, đổi nghĩa, hoặc được “chốt hộ” không?
Chỉ ghi “đạt” khi cả ba điều kiện đều đạt; nếu không, ghi lỗi cụ thể và câu nguồn đối chiếu. Đừng chấm cao chỉ vì văn phong mượt. OpenAI cũng khuyến nghị tiêu chí rõ và kiểm tra đạt/không đạt, thay vì chỉ đánh giá bằng cảm giác.
4. Lưu trước khi sửa prompt
Trong một bảng tính, mỗi dòng là một ca: mã ca, ghi chú nguồn, đáp án kỳ vọng, prompt, tên model hiển thị, ngày chạy, đầu ra nguyên văn và lỗi. Ghi thêm bối cảnh như chat mới hay chat cũ, tệp hoặc công cụ kèm theo. Nếu không biết phiên bản model thực tế, ghi “không biết”.
Giữ nguyên 6 đầu vào, sửa một yêu cầu trong prompt rồi chạy lại. So cả ca từng đúng lẫn ca từng sai để tránh sửa lỗi này nhưng làm hỏng chỗ khác. Nếu lặp lại, lưu mọi lượt thay vì chỉ chọn kết quả đẹp nhất. Với chỉ 6 ca, ghi số ca đạt và lỗi từng ca sẽ hữu ích hơn một tỷ lệ trông có vẻ chính xác.
Giới hạn cần biết: bộ kiểm tra nhỏ chỉ giúp nhận diện lỗi trên các ghi chú đã chọn, không chứng minh model nào tốt nhất hay lý do chất lượng thay đổi. Không có đầu ra cũ đã lưu thì chưa thể kết luận hiện tại tệ hơn trước. Việc nhờ một AI khác chấm cũng không thay thế hoàn toàn kiểm tra của người đọc; OpenAI khuyến nghị đối chiếu cách chấm tự động với đánh giá của con người.
Việc làm ngay: tạo một ghi chú có người và hạn rõ, cùng một ghi chú cố tình thiếu hạn. Kiểm tra xem AI có biết giữ phần “chưa nêu” thay vì tự điền giúp bạn không.
0 bình luận
Chưa có bình luận nào. Hãy trở thành người đầu tiên!